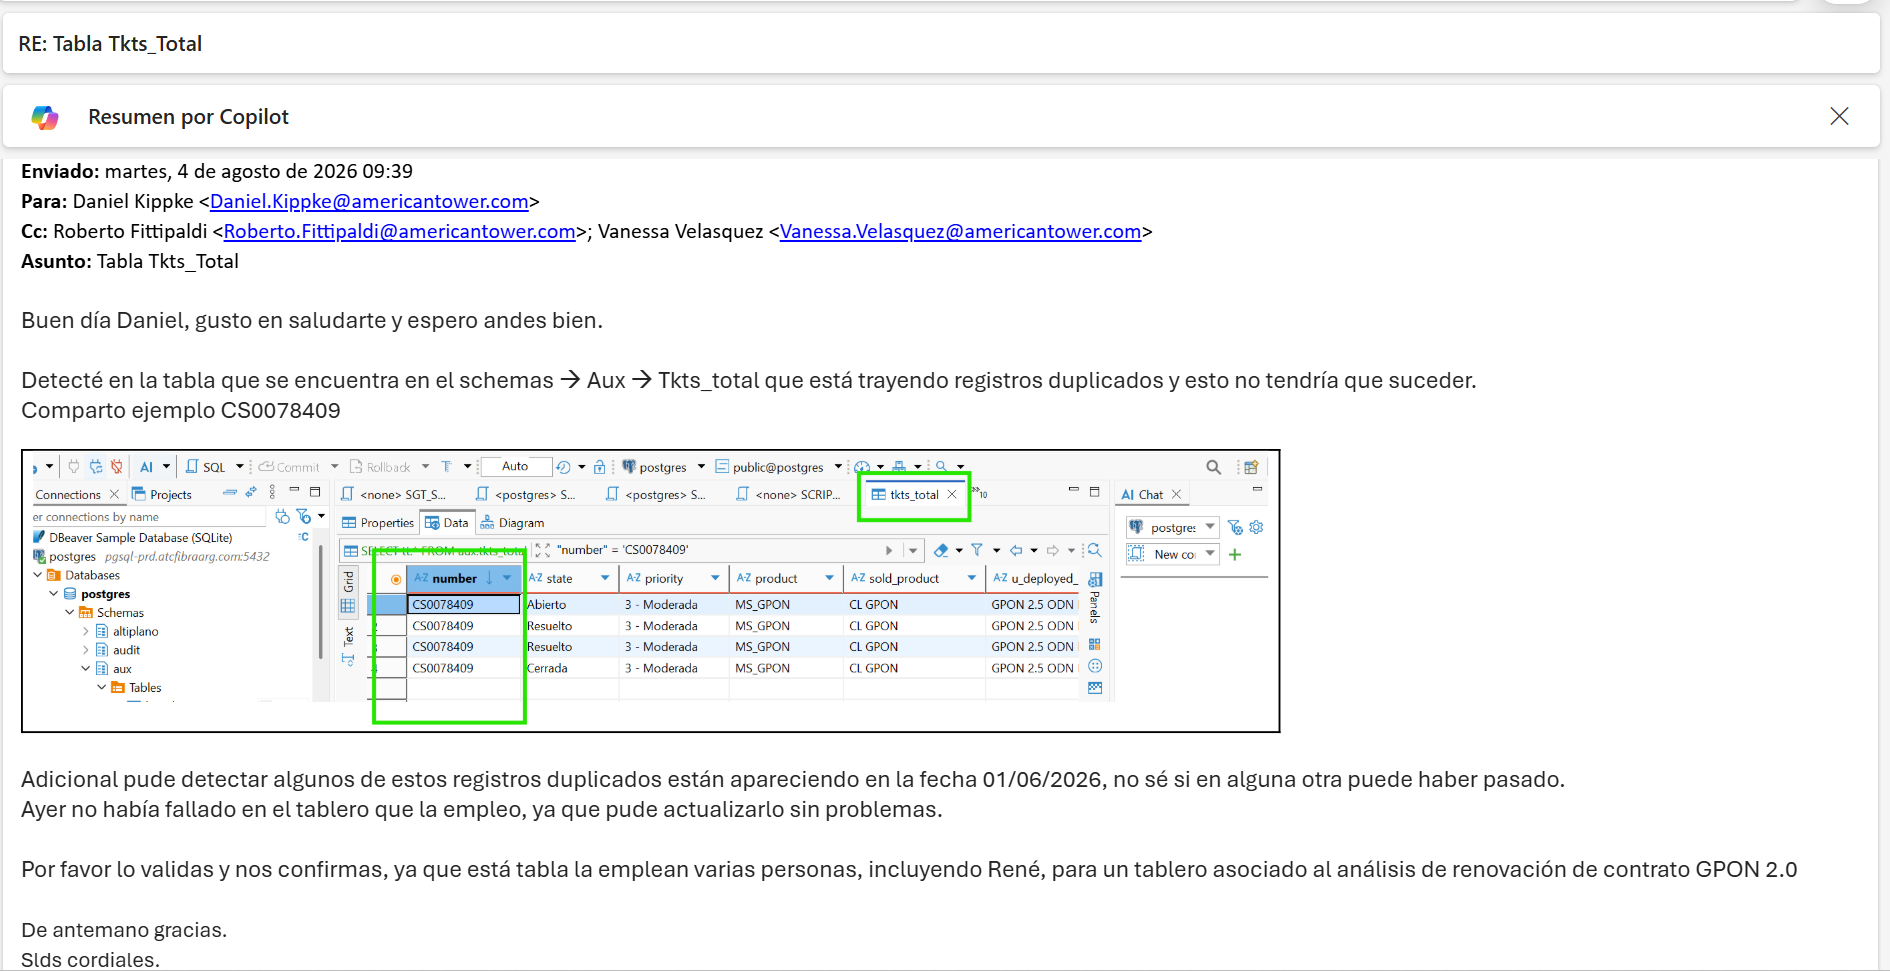
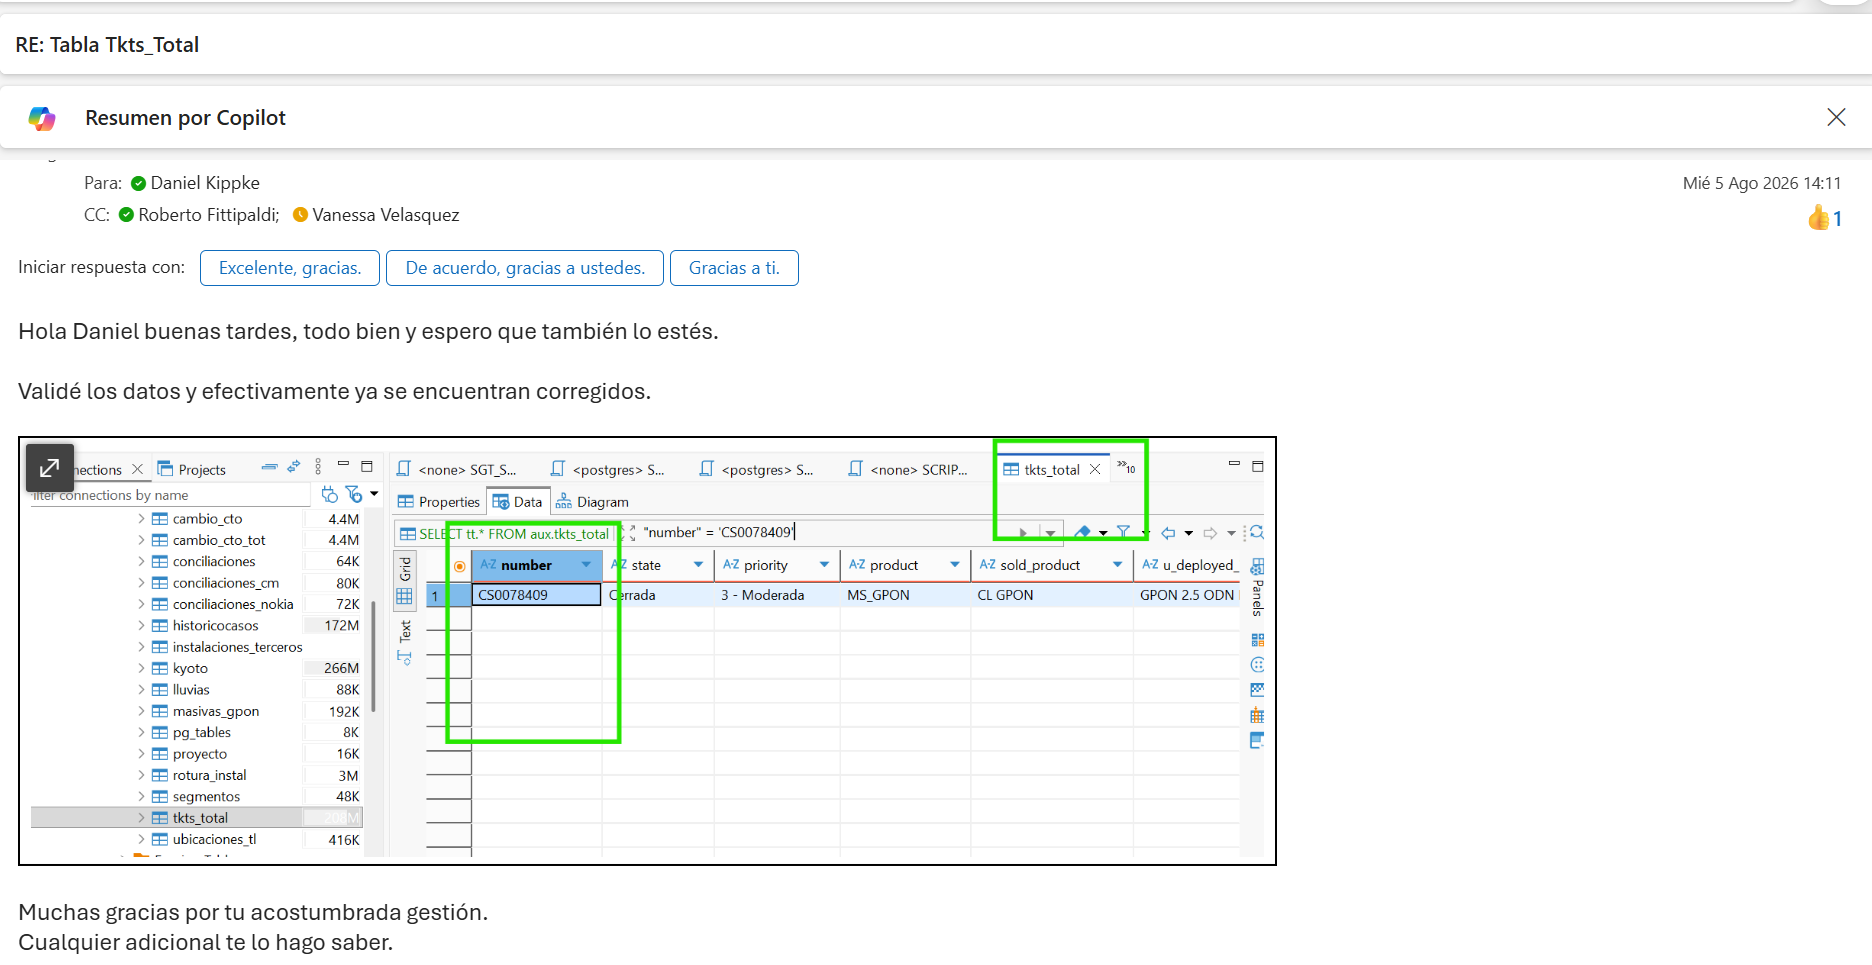
Al ejecutar la siguiente query obtuve todos los elementos que tenían duplicados.
SELECT
number,
COUNT() cantidad
FROM aux.tkts_total
GROUP BY number
HAVING COUNT() > 1
ORDER BY cantidad DESC;
En algunos casos aparecían hasta 6 o 7 veces.
Me puse a investigar y los datos son cargados por el script
upload_incidentes_tkts_total_RF18062025
El cual lee información de un excel ubicado en /Argentina/OyM/Incidentes/Tabla_historica
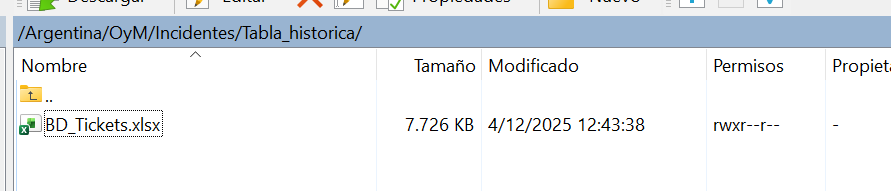
En esa planilla los datos aparecen sólo una vez, por lo que son el origen de la duplicación.
Sigo investigando, y la otra fuente de información es la tabla sn.case, la cual tampoco tiene datos duplicados. Esta tabla se genera con el script sn2psql. Una versión de este script me había generado registros duplicados al momento de probar la versión staging.
Al observar en la tabla, veo que los casos de duplicados correspondían a dos fechas en particular, por lo que asumí que fueron fechas en las que probé el script de sn2psql staging. ESE es el origen de los duplicados!
Con la siguiente query eliminé todas las filas duplicadas, dejando la última cargada
WITH ordenados AS (
SELECT
ctid,
ROW_NUMBER() OVER (
PARTITION BY number
ORDER BY
TO_TIMESTAMP(
SUBSTRING(
comments_and_work_notes
FROM '([0-9]{2}-[0-9]{2}-[0-9]{4} [0-9]{2}:[0-9]{2}:[0-9]{2})'
),
'DD-MM-YYYY HH24:MI:SS'
) DESC NULLS LAST,
resolved_at DESC NULLS LAST,
ctid DESC
) AS posicion
FROM aux.tkts_total
)
DELETE FROM aux.tkts_total t
USING ordenados o
WHERE t.ctid = o.ctid
AND o.posicion > 1;